“Se um agente de IA já cuida do Git para você, por que aprender outro sistema de controle de versões, como o Jujutsu?”
Essa foi a objeção mais comum ao meu último post, 15 anos de Git e depois Jujutsu: por que não consigo mais voltar. É uma dúvida legítima, e também interessante, então este post é a minha resposta.
Concordo que o controle de versões do dia a dia é trabalho para um agente de IA. É exatamente assim que eu trabalho. A diferença é que os comandos que meus agentes executam são do Jujutsu, não do Git. Depois de experimentar os dois jeitos, estou convencida de que, mesmo com a IA no comando, o Jujutsu oferece uma experiência de desenvolvimento muito melhor, e de que o tempo investido para aprendê-lo se paga rapidamente.
Antes de apresentar meus argumentos, vale esclarecer logo uma dúvida óbvia: a IA consegue mesmo lidar com o Jujutsu? Testei com Opus, GPT, Gemini e outros. Os modelos mais recentes já conhecem nativamente os conceitos básicos e os principais comandos do Jujutsu, e conseguem cuidar das operações do dia a dia sem carregar nenhuma skill extra. Dito isso, o Jujutsu não está tão integrado às ferramentas dos agentes quanto o Git, então é preciso alguma configuração para impedir que o agente volte ao Git sem avisar e para ensinar a ele um fluxo de trabalho adequado ao Jujutsu. Esta é a configuração que eu uso.
A cerimônia do commit no Git versus os changes sem atrito do Jujutsu
No Git, a unidade básica do histórico é o commit. O fluxo padrão é assim: você edita arquivos na working tree, escolhe os que quer e os adiciona ao índice, depois escreve uma mensagem e cria um commit. Só então algo entra no histórico. Um commit foi pensado para ser um produto acabado, algo feito com cuidado, e é por isso que o Git oferece o índice como staging area. Editar um arquivo e registrar essas alterações no histórico exige uma sequência longa e rígida de passos. É quase um ritual.
Então, mesmo quando você entrega o Git a uma IA, continua terminando cada tarefa com o pedido “faça o commit disso”. Peça qualquer operação no histórico no meio de uma tarefa e lá vem a troca de sempre: “Há alterações sem commit. Devo guardá-las no stash ou fazer o commit primeiro?”. Cada rodada talvez leve só meio minuto, mas acontece o tempo todo, e tudo isso vai somando. Há também um custo cognitivo, pago tanto por você quanto pela IA, mesmo que você não perceba.
No Jujutsu, a unidade básica do histórico é o change. Quando você inicializa um repositório, começa em um change vazio. Cada edição que você faz ali é salva, conforme você trabalha, como uma nova revisão desse change1. Você pode adicionar uma descrição, o equivalente no Jujutsu a uma mensagem de commit, quando quiser. Um change nunca tem um momento em que fica oficialmente “pronto”2. Quando termina o trabalho, você simplesmente segue em frente.
Isso significa que, quando uma IA opera o Jujutsu por você, basta deixar uma instrução fixa: começar cada tarefa em um change novo, com uma descrição3. A partir daí, você só diz “crie a funcionalidade X”, e o histórico fica dividido em unidades razoáveis que acompanham o fluxo do trabalho. Chega de “faça o commit disso” no fim de cada tarefa, e chega de ter que arrumar a cópia de trabalho antes de uma operação no histórico.
O Jujutsu é compatível com o Git, mas não existe índice entre o seu diretório de trabalho e o seu repositório local. Além disso, o estado do seu diretório de trabalho é o ponto atual do histórico (o Jujutsu chama isso de “working copy as a commit”, a cópia de trabalho como commit). No Git, tanto pessoas quanto a IA precisam acompanhar três estados para cada alteração em um arquivo. No Jujutsu, normalmente há só um. Só depois de migrar percebi quanto esforço mental extra eu gastava para me adaptar ao jeito do Git de fazer as coisas, e como todo aquele controle era estressante.
Alguns de vocês vão dizer que isso não incomoda nem um pouco. Tudo bem. Muita gente realmente não se importa de vestir terno e chegar ao escritório às 8h30 todas as manhãs. Mas imagine sair disso para um emprego sem código de vestimenta, com horário flexível e trabalho remoto até três dias por semana, e achar tudo tão confortável que não daria mais para voltar. Foi isso que senti com a mudança.
O Jujutsu facilita desfazer os erros da IA
Pessoas erram, e a IA também. Ainda vejo, de vez em quando, relatos de agentes de IA que apagaram arquivos em que alguém estava trabalhando, sem nenhum jeito de recuperá-los. Peça a um agente para resolver um conflito e não é raro receber um resultado que passa nos testes, mas está semanticamente quebrado. E como as instruções aos agentes são dadas em linguagem natural, um prompt nem sempre transmite bem a sua intenção, então muitas vezes você não vai ficar satisfeito com o que recebe.
Quando a IA executa comandos do Git como parte do trabalho, recuperar-se de um resultado ruim fica muito mais difícil. O Git não tem como voltar o repositório inteiro ao estado em que estava antes de uma determinada operação. Como mencionei, o Git guarda estado em vários lugares: a working tree, o índice, o stash e os commits, e cada um tem sua própria forma de proteção, quando existe alguma. Rebase, amend e squash não modificam os commits existentes. Eles criam commits novos e movem o branch para eles, de modo que os originais deixam de ser referenciados por qualquer branch. Eles continuam no reflog, mas encontrar depois a entrada certa, enterrada no meio de todo o resto, é uma verdadeira dor de cabeça.
Para compensar o fato de o Git não salvar alterações sem commit, o Claude Code oferece o comando /rewind, que volta o código a um ponto anterior junto com a conversa. Mas ele não combina bem com um agente que executa comandos do Git. Seus arquivos voltam, mas o estado do Git não, então de repente o git status mostra uma pilha de alterações que você nunca quis, e lá vai você arrumar o histórico de novo. E o que tiver sido alterado por comandos do shell, por você ou por outros agentes rodando em paralelo não é revertido de jeito nenhum.
Se você percebe um erro na hora, ainda está numa boa. Mas o mais comum é ele aparecer depois, quando você roda os testes após continuar trabalhando ou quando revisa as coisas dias mais tarde. A essa altura, fica muito mais difícil desembaraçar tudo. Mais operações se acumularam em cima da errada e, mesmo que você mergulhe de cabeça no reflog, nada garante que uma longa série de passos delicados vai resolver. Pior: o Git não oferece nenhum jeito de desfazer a própria tentativa de recuperação. Uma IA que tenta uma correção atrás da outra para sair do buraco pode facilmente piorar as coisas.
O Jujutsu resolve quase tudo isso. Como regra geral, o resultado de qualquer comando jj pode ser revertido com jj undo, e o próprio undo pode ser desfeito com jj redo. Isso é possível porque o Jujutsu mantém, separado do log normal, um registro de cada operação que altera o repositório: o operation log. Cada entrada do operation log está ligada a um snapshot do repositório como ele ficou ao final daquela operação. Você pode restaurar os arquivos para esse estado, ou reverter só o efeito daquela operação, mantendo tudo o que veio depois.
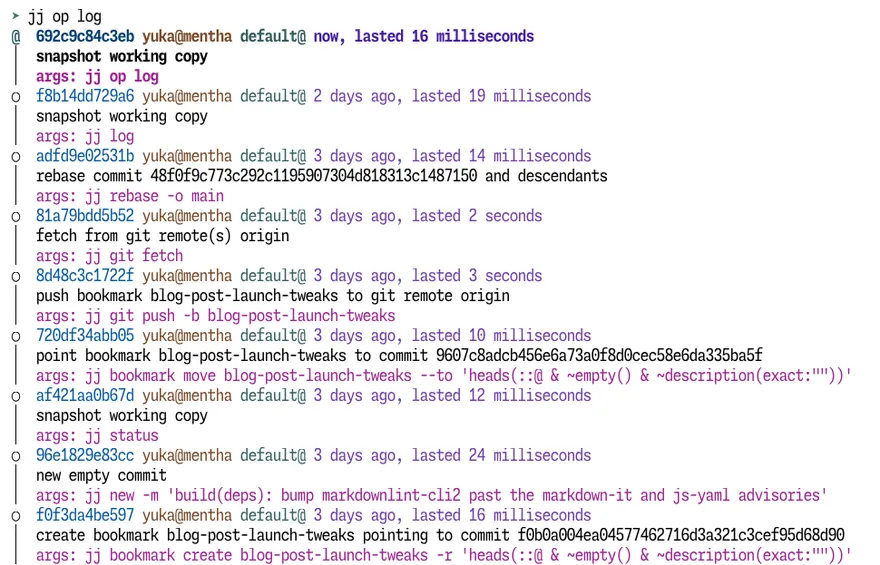
Cada comando jj que uma IA executa durante uma longa sessão de tentativa e erro também vai parar no operation log. Quando algo dá errado, você pode repassar tudo o que a IA fez, identificar a causa e voltar ao estado logo antes de as coisas desandarem.
Além disso, ao contrário do hash de um commit do Git, que muda toda vez que você edita o commit, o change ID do Jujutsu continua o mesmo, não importa quantas vezes o change seja revisado. Você pode consultar o histórico de revisões de um change no evolution log e, com um pouco de garimpo, encontrar uma versão anterior e restaurar seu conteúdo. Usando a data e a hora ou o diff como referência, dá até para se recuperar de uma resolução de conflito malfeita de vários dias atrás e refazê-la.
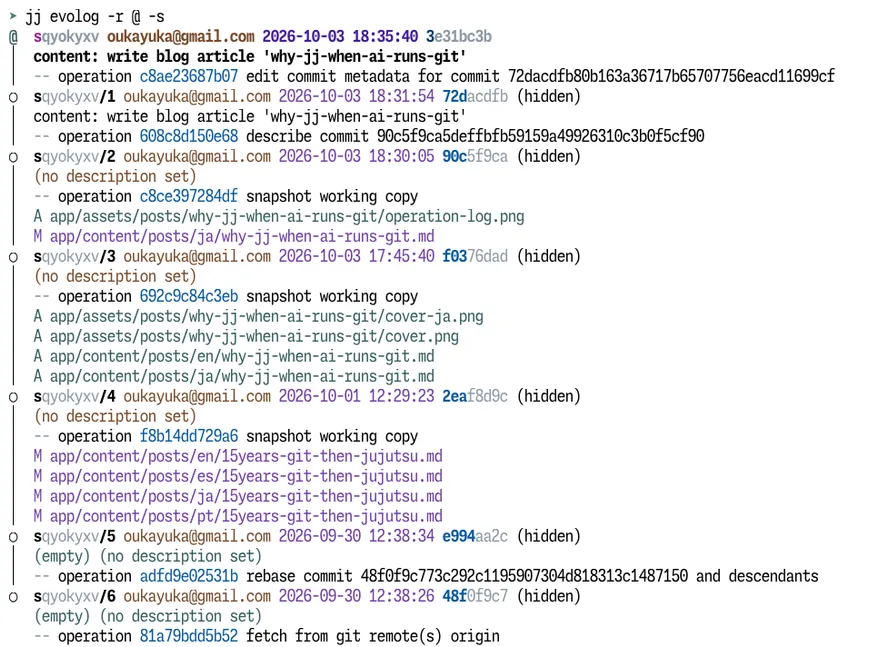
Cada edição é salva no histórico conforme você trabalha. O operation log e o evolution log permitem encontrar onde as coisas deram errado e voltar a esse ponto. E se a própria recuperação der errado, jj undo e jj redo deixam você tentar de novo na mesma hora. É um nível de segurança que o Git simplesmente não oferece, e é exatamente por isso que, com o Jujutsu, consigo entregar o controle de versões a uma IA com mais tranquilidade, e com mais ousadia, do que jamais consegui com o Git.
Por que um histórico limpo importa mais na era da programação com IA
Outro comentário que se destacou no meu último post foi “não faço questão de manter o histórico limpo, então não vejo sentido no Jujutsu”. O raciocínio parece ser que, mesmo que o histórico esteja uma bagunça, basta pedir à IA para encontrar o que você precisa. Mas será que é assim mesmo? Eu diria que é o contrário: justamente porque, com a IA, escrevemos e lemos menos código, um histórico limpo importa mais do que nunca.
Os agentes de programação melhoraram tanto que muitos desenvolvedores hoje mal escrevem código e também não leem cada linha que a IA gera. Mesmo assim, eles continuam zelando pela qualidade do que vai para produção, seja pedindo a um agente com outro modelo que revise o trabalho, seja conferindo pessoalmente as partes críticas, como mudanças em estruturas de dados. Se você consegue rastrear direto no histórico o que mudou, por que e do que depende, tudo isso fica mais rápido e com menos erros. Justamente porque ninguém está revisando cada linha, seu histórico de commits precisa funcionar como o sumário do código, para que você encontre as partes que importam. Uma sequência de commits gigantes sem intenção clara obriga a IA a carregar contexto irrelevante toda vez, o que gasta tokens e pode prejudicar a qualidade do trabalho dela.
No início de cada sessão, um agente costuma olhar primeiro os diffs significativos mais recentes, antes do diretório de trabalho como um todo. Enfie “uma correção de bug + uma atualização de dependências + conteúdo sem relação + uma refatoração que não tem nada a ver” em um único commit, e o agente se confunde. Organize commits de tamanho razoável e com intenção clara, numa ordem que reflita a relação de causa e efeito, e até um prompt curto vai dar ao agente o contexto de que ele precisa para a próxima tarefa.
E mesmo que você quase não leia o código gerado pela IA durante o desenvolvimento, um incidente vai obrigar você a lê-lo com atenção. A primeira pergunta diante de uma queda em produção é “quando e onde entrou o código problemático?”. Quando cada minuto conta, um histórico de commits semanticamente coerentes ajuda você a localizar o problema rapidamente.
A programação com IA também criou um problema novo ao disparar a produtividade: os PRs ficam enormes → fica difícil revisá-los → PRs sem merge se acumulam à espera de revisão. Agora até equipes de poucas pessoas caem nesse ciclo. Gigantes de tecnologia como Google e Meta lidam com esse problema há mais de uma década, e a resposta delas tem sido “dividir os PRs em unidades pequenas que dependem umas das outras”. Suponha que você normalmente enviaria uma funcionalidade inteira como um único PR. Em vez disso, você cria quatro PRs: “1. alterações na camada de modelo”, “2. alterações nas tarefas agendadas”, “3. alterações na API do servidor” e “4. alterações no frontend web”. Depois, empilha esses PRs na ordem 1 → 2 → 3 → 4. Cada um pode ser revisado, aprovado e receber merge separadamente, mas um PR só pode receber merge depois que os PRs abaixo dele na pilha (no caso do 3, o 1 e o 2) já tiverem entrado. Essas empresas incorporaram esse fluxo às suas ferramentas e passaram a usá-lo no desenvolvimento do dia a dia.
PRs pequenos e com um papel lógico claro facilitam a vida de quem revisa, e fica mais fácil identificar quais você precisa revisar. As alterações no branch de um PR mais abaixo na pilha se propagam automaticamente para os branches acima dele, com o rebase feito pelas ferramentas. E, graças às dependências, você pode começar com segurança a próxima parte do trabalho enquanto o primeiro PR ainda espera revisão. É isso que se costuma chamar de stacked diffs ou stacked PRs. Graphite, GitButler, GitLab e outros vêm oferecendo suporte há anos. E, em julho de 2026, o GitHub finalmente lançou os stacked PRs em versão prévia pública. Com o maior player a bordo, tudo indica que a tendência vai ganhar força.
Entre a popularização dos monorepos e o impacto dos agentes de IA, a demanda por stacked PRs está crescendo não só nas grandes empresas, mas também nas pequenas e médias. Quando os stacked PRs passam a fazer parte do jeito de trabalhar de uma equipe, acertar as unidades do histórico e a ordem delas vira parte do trabalho de cada desenvolvedor. PRs em que antes cabia de tudo agora precisam ser divididos pelo papel lógico, com dependências entre eles. E o Jujutsu torna isso fácil e seguro.
Pense em dividir um commit gigante em unidades com sentido. É uma tarefa difícil, até para a IA. No Git, você provavelmente faria git reset HEAD^ para devolver o commit inteiro à working tree e depois repetiria o ciclo de adicionar ao índice e fazer commit, pedaço por pedaço. Se você errar no meio do caminho, recuperar-se significa descobrir exatamente até onde a divisão chegou e quais edições ficaram onde, o que já é uma dor de cabeça por si só. E se o commit que você quer dividir for antigo, prepare-se para a emoção de encadear rebases com o HEAD desanexado (detached HEAD). No Jujutsu, você passa os arquivos para jj split -m <description> e pronto. Se errar, desfaz e tenta de novo. Quando quem faz isso é uma IA, a divisão é por arquivo, mas uma pessoa operando o Jujutsu pode usar jj split -i para dividir de forma interativa, linha a linha, ou consultar o evolution log e dividir o trabalho na ordem em que ele foi realmente feito.
Transformar um branch de trabalho em uma cadeia de branches dependentes para um stacked PR dá muito trabalho no Git. No Jujutsu, basta ir colocando bookmarks, um depois do outro, em uma única linha do histórico. A documentação oficial do GitHub inclusive mostra, passo a passo, como montar a cadeia de branches de um stacked PR com o Jujutsu4. É bom ver essa afinidade reconhecida oficialmente.
O que é fácil para pessoas também é fácil para a IA
O Git foi projetado colocando as funcionalidades à frente de quem usa. O Jujutsu é um sistema de controle de versões criado para resolver os pontos fracos do Git5 e para manter a carga cognitiva das pessoas o mais baixa possível. E o que é fácil para a mente humana acaba sendo fácil para a IA também. Você nunca precisa se preocupar se uma edição já entrou no histórico, porque o estado do diretório de trabalho é o ponto atual do histórico. Um change mantém o mesmo ID não importa quantas vezes seja revisado, então ele nunca se perde durante longas rodadas de tentativa e erro. O operation log registra cada operação em ordem, então é fácil ver qual passo deu errado e restaurar a partir dali. E quando surge um conflito no meio de uma tarefa, o próprio estado em conflito é salvo no histórico, então você pode ir com calma e tentar resolvê-lo quantas vezes precisar. Cada uma dessas características é uma grande vantagem quando é a IA que está no comando.
O Jujutsu não está tão integrado às ferramentas dos agentes de IA quanto o Git. Mas é muito mais fácil para esses agentes entenderem como ele funciona, o que tende a tornar o trabalho deles mais estável e seguro. Mesmo que você entregue à IA o controle de versões junto com a programação, escolher o Jujutsu para essa tarefa faz todo o sentido.
Essa é a minha opinião, e também o argumento que desenvolvo no “Capítulo 1: Que tipo de ferramenta é o Jujutsu?” do meu livro, Juju-chu! — Comece seu fluxo de trabalho Jujutsu × IA com `jj new`. O capítulo desenvolve esse argumento ao explorar cada funcionalidade. O “Capítulo 3: Fluxo de trabalho Jujutsu × IA na prática” é um passo a passo prático de como realmente entregar a operação do Jujutsu ao Claude Code e ao Codex.
Juju-chu! — O guia de Jujutsu para programar com agentesUm guia prático para adotar Jujutsu (jj) com Claude Code e Codex: snapshots automáticos, operações que podem ser desfeitas e reescrita segura do histórico.
Se este post despertou sua curiosidade pelo Jujutsu, dê uma olhada.
Footnotes
-
Para ser exata, sempre que qualquer comando
jjé executado, o Jujutsu compara a cópia de trabalho com o estado mais recente do histórico. Se houver diferenças, ele tira um snapshot e o change ganha uma nova revisão. Se você usa uma interface gráfica do Jujutsu, ela normalmente tira um snapshot automaticamente sempre que você consulta o histórico nela. ↩ -
Um detalhe: um change sem descrição não pode ser enviado ao remoto com push. ↩
-
Veja Faça seu agente de programação usar Jujutsu em vez de Git. ↩
-
Usar outras ferramentas com solicitações de pull empilhadas - Documentos do GitHub ↩
-
Solving Git’s Pain Points with Jujutsu (with Martin von Zweigbergk) - YouTube ↩