「AI が面倒な Git の操作もやってくれるので、今からわざわざ Jujutsu に乗り換える気にならない」
反響が大きかった前回の記事「Jujutsu と出会い、15 年使った Git にもう戻れなくなった理由」ですが、そこでいただいたコメントでもっとも多かったのがこのような趣旨のものでした。非常に興味深いテーマなので、今回はこれについての私見を語ろうと思います。
日常的なバージョン管理の操作は AI エージェントに任せたほうがいいというのは私も同感で、実際に日々の開発作業でそのようにしています。ただし任せているのは Git の操作ではなく、Jujutsu の操作ですが。両方を経験したうえで、AI に操作を任せる前提でも Jujutsu を使うほうが開発者体験がずっといい、そのための学習コストはすぐに回収できると私は考えます。
その論拠を説明する前に、「AI は Jujutsu をちゃんと扱えるの?」という疑問がありそうなので、それに答えておきましょう。Opus や GPT、Gemini などと対話して確かめたのですが、それらの最新モデルはデフォルトで Jujutsu の基本概念と主要コマンドを知識として持っており、別途 skills などを読み込むことなく日常的な操作を行うことができます。ただし Git のように公式にネイティブサポートしているわけではないため、エージェントが不意に Git に戻ろうとするのを押し留めたり、Jujutsu に適したワークフローを教えたりする設定が必要になります。私の場合はこんな設定を適用しています。
厳格な commit (git) とカジュアルな change (jj)
Git の基本的な履歴の単位は commit です。まずファイルの変更を working tree で行い、そこから必要なファイルを選んで index に乗せ、最後に message を付けて commit を作り、そこで初めて履歴に保存されるというのが基本的なワークフローになります。commit は最終的な完成品であり、慎重に作られるべきものであるがゆえ、index という準備空間が用意されているわけですね。ファイルの変更から履歴に保存されるまでに必要なステップが長く厳格で、まるで儀式のようです。
そのため Git の操作を AI に任せるとしても、ひとつのタスクの終わりに 「commit して」 という依頼が毎回必要になります。作業中に履歴操作を依頼するときも、「未 commit の変更があります。stash しますか? 先に commit しますか?」 というやりとりが発生します。このルーチンは 1 回数十秒程度であっても、頻繁に起きるものなので全体としては馬鹿になりません。またそれに伴う認知コストは、意識していなくても人間と AI 双方に発生しています。
Jujutsu では履歴の基本的な単位は change です。リポジトリを初期化すると、まず空の change が作られます。そこでのファイルの変更は、ことあるごとに改訂履歴として保存されます1。commit message に相当する description はいつ付けてもかまいません。change には完成という節目などはなく2、作業が終わったらそこを離れるだけです。
そのため Jujutsu の操作を AI に任せる際、開始時に description を設定した change を作るように指示しておけば3、「〇〇の機能を作って」とタスクの依頼をするだけで、履歴が文脈に沿った適切な単位で区切られます。毎回の「commit して」は不要ですし、履歴操作を依頼しても working copy(作業ディレクトリ)の整理を迫られることはありません。
Jujutsu は Git と互換性がありますが、作業ディレクトリとローカルリポジトリの間に index が存在しないばかりでなく、作業ディレクトリの状態がカレントの履歴ポイントそのものとして扱われます(Working-copy-as-a-commit)。Git ではファイルの変更について AI も人間も 3 つの状態を認識する必要がありましたが、Jujutsu ではそれが通常ひとつだけなのです。Jujutsu に移行したことで、いかに Git の流儀のために余計な認知コストを払い、その辻褄合わせの作業にストレスを感じていたかに私は気付かされました。
「自分はそれが面倒だと思わない」と主張する人もいるでしょう。世の中には毎日スーツを着て朝 8 時半までに出勤するのが苦にならないという人も少なからずいるわけですから。しかしそこから普段着で働けて勤務時間はフレックス、週 3 回までリモート勤務 OK という職場に移って、快適すぎて戻れなくなった。私の実感を例えるならそういうことです。
Jujutsu は AI の失敗を簡単に巻き戻せる
人間はミスをしますが、AI もミスをします。AI エージェントに作業中のファイルを消されて戻せなくなったという報告は今もときどきありますし、conflict の解消を頼んだらテストは通るけれども意味的には壊れているような結果になることもめずらしくありません。また AI コーディングではエージェントへの指示は自然言語で行うため、プロンプトによっては自分の意図がうまく伝わらず、結果に不満を感じることも少なからずあるでしょう。
AI が作業の中で Git 操作を行っていると、結果が失敗だったときの回復作業の難易度が跳ね上がります。Git にはリポジトリ全体を、ある操作の前の状態に戻すしくみがありません。先述したように Git では状態の置き場が working tree、index、stash、commit と複数あり、その守られ方もバラバラです。rebase や amend、squash は既存の commit を変更するのではなく新しい commit を作って付け替えるため、元の commit はどの branch からも参照されなくなり、後から reflog で探すのも至難の業です。
commit されてないファイルの変更履歴が Git に保存されないのを補うものとして、Claude Code は会話と共にコードの状態を過去の特定のポイントまで巻き戻せる /rewind コマンドを提供していますが、エージェントによる Git 操作とはやはり相性が良くありません。ファイルは戻っても Git の状態は戻らないため git status には意図しない差分が大量に現れ、再度履歴を整理する必要に迫られます。またシェルコマンドによるファイル操作、人間や並列で動かしている他のエージェントによる編集などが混ざっていると、それらは戻りません。
失敗が起きてもその場で気づけばまだいいのですが、発覚するパターンの多くは作業を進めてテストを走らせたときや後日レビューしたときなどで、そうなるとほぼ取り返しがつきません。その時点では失敗した操作の上にさらに操作が積み重なっており、reflog を駆使したとしても綱渡り作業の連続の末にちゃんと直せる保証はない。また Git では純粋に回復操作そのものを巻き戻すための手段が提供されていないため、AI が失敗を挽回するために別の修正を次々と試した結果、状況をさらに悪化させてしまうこともありえます。
Jujutsu を使うと、これらの懸念のほとんどが解消されます。すべての jj コマンド実行による結果は、基本的に jj undo で巻き戻せます。そして undo の実行自体も jj redo で取り消せます。なぜそれが可能なのかというと、Jujutsu ではリポジトリに変更があった際の操作を operation log として通常のログとは別に持っているから。operation log の各ノードにはその操作終了時のリポジトリのスナップショットが結びついており、後からそのときのファイルの状態を現在に復元したり、積み上げた履歴からその操作の結果のみを打ち消したりできるのです。
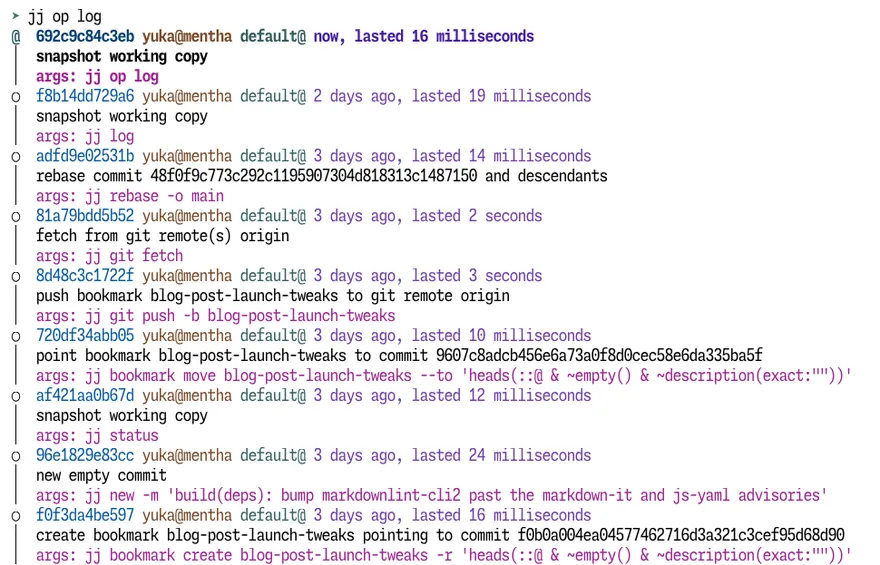
AI が長い試行錯誤の中で実行した jj コマンドも operation log にすべて記録されています。そこで何かがおかしくなったときに、AI がどんな操作を行ったかを俯瞰して原因を特定し、おかしくなる直前の状態に戻すことも Jujutsu なら可能です。
また編集すると毎回変更される Git の commit hash と異なり、Jujutsu の change ID は何度改訂されても変わりません。そして change の改訂履歴は evolution log として閲覧でき、それをたどれば過去の版の内容を復元することも可能です。改訂の日時や diff で特定すれば、数日前にやらかした conflict 解消の失敗なども復元してやり直せます。
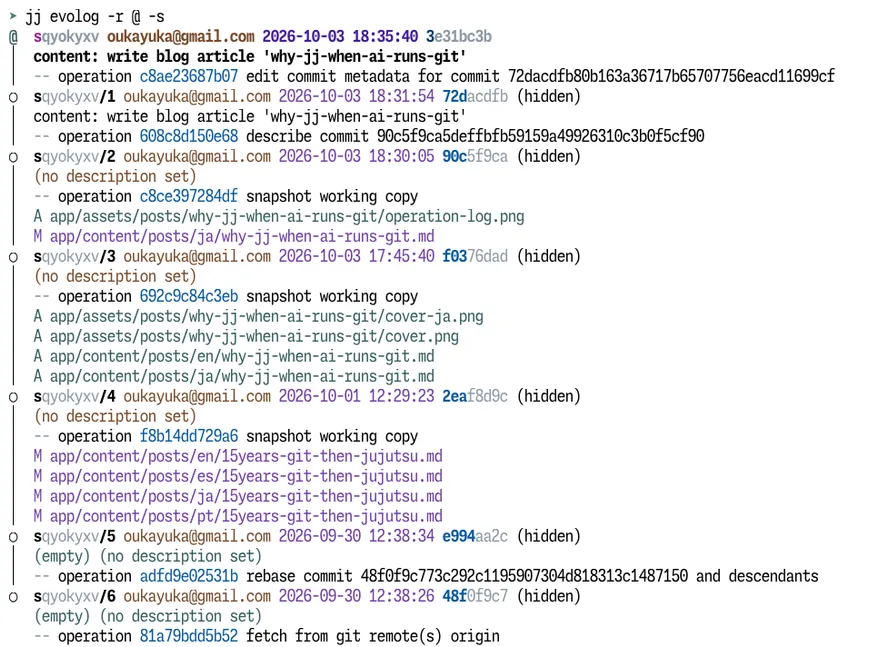
ファイルの変更が逐次履歴に保存され、operation log と evolution log で問題が起きた地点を特定して戻すことができる。かつ回復作業そのものも、しくじったら jj undo や jj redo ですぐやり直すことができる。この絶対的な安心感があるからこそ、Jujutsu では Git よりも AI に気軽かつ大胆にその操作を任せることができるのです。
AI コーディング時代に履歴をきれいにすることの意義
前回の記事で他に目立ったコメントに 「自分は履歴をきれいにする気がないので、Jujutsu を使う必然性を感じない」 というものがありました。履歴が汚くても AI に頼めば、そこから必要な情報を教えてくれるからということのようです。しかし本当にそうなのでしょうか? むしろ AI によって人間がコードを書いたり読んだりする機会が減ったからこそ、履歴をきれいにする必要性が増していると私は考えます。
コーディングエージェントの性能が著しく向上したため、もう自分ではほとんどコードを書いていない、そして生成されたコードも逐一目を通していないという開発者が今ではめずらしくなくなっています。しかしそういう人たちでも、別のモデルのエージェントにレビューをさせたり、データ構造の変更など肝心な部分は自分でチェックすることで成果物の品質を担保しています。何を、なぜ、何に依存して変更したかというのが意味論的に履歴からたどれるようになっていれば、それらの作業の効率が高まりますし、ミスも少なくなります。人間がすべてのコードをチェックしていないからこそ、必要な場所を特定するために commit 履歴はコードを理解するための目次 になっている必要があるのです。意図の不明な巨大 commit が漫然と並んでいる状態では AI も毎回不要な情報までコンテキストに取り込むことになり、無駄なトークンを消費しますし、作業の精度にも影響しかねません。
エージェントは毎回のセッションで作業ディレクトリ全体より、直近の意味のある差分をまず読むことが多いです。ひとつの commit に「不具合の修正+依存パッケージのアップデート+他のコンテンツの追加+関係ないリファクタリング等々」が詰め込まれている状態では、エージェントが混乱します。いっぽう粒度が合理的で意図が明確な commit が適切な因果関係で並んでいれば、短いプロンプトでも次の作業の前提がエージェントに伝わりやすくなります。
それに開発時には AI が生成したコードをほとんど読まない運用であっても、インシデントが発生した際は丁寧に読む必要に迫られます。本番障害での最初の問いは「悪さをするコードがいつどこで入ったか」です。1 分 1 秒を争う状況の中、意味論的に整った履歴は問題箇所の迅速な特定に役立ってくれます。
また一方で AI コーディングにより開発の生産性が大きく上がった結果、現場では新たな問題が生じました。「PR が巨大になりがち」→「レビューしづらくなる」→「レビュー待ちで未マージの PR が大量に積み上がる」 という困った状況が、わずか数名規模のチームにも起きるようになってしまったのです。この問題は 10 年以上前から Google や Meta といったビッグテックが直面してきたものであり、それを解消するために彼らが実践してきたのが「PR を依存関係を持つ小さな単位に分割する」という方法です。たとえばこれまでひとつの機能の実装をひとつの PR として提出していたものを、「1. モデル層の変更」「2. 定期実行タスクの変更」「3. サーバ API の変更」「4. Web フロントエンドの変更」のように分割して 1 → 2 → 3 → 4 と積み上げ、それぞれ個別にレビュー・承認・マージができるようにする。ただしマージについては下層の PR(例: 3 にとっての 1 と 2)がマージされて初めて可能になる、というのを彼らはシステムとして導入・運用していました。
PR の規模が小さく論理的な役割が明確なため、レビュアーの心理的負担が小さく、自分の担当すべきものを見つけやすい。さらにスタック下層の PR branch での変更は、システムによって上層の PR branch に自動的に波及・rebase されます。最初の PR がレビュー待ちであっても、依存関係があることで安全に並行して次の作業が始められます。これが一般に Stacked Diffs や Stacked PRs と呼ばれるものですが、Graphite や GitButler、GitLab などがすでに数年前からその仕組みをサービスとして順次提供しています。そしてついに GitHub も 2026 年 7 月から GitHub Stacked PRs をパブリックプレビューとして提供開始しました。本命が動いたことで、このトレンドは今後さらに弾みがつきそうです。
モノレポの一般化と AI エージェント導入による影響があいまって、Stacked PRs へのニーズが大企業のみならず中小の事業者からも高まっています。Stacked PRs が現場に導入されるようになれば、履歴の単位と並びの順番を整えることはチームにおける開発者の義務になるでしょう。これまでごちゃまぜに詰め込んでいてもよかった PR を論理的な役割によって分割し、それらに依存関係を持たせる必要があるのですから。そして Jujutsu ならそれが簡単かつ安全に行えます。
たとえば巨大になってしまった commit を意味論的な単位に分割するのは、AI にとっても難しいタスクです。Git だと commit をいったん git reset HEAD^ で working tree に全部戻し、部分的に index → commit を繰り返すことになるでしょうか。途中で操作を誤ると、どこまで分割できていて、どの変更がどこに残っているのかを正確に把握しての回復作業はたいへんです。対象が過去の commit なら、detached HEAD の状態で rebase を繰り返すという、非常にスリリングな作業になります。いっぽう Jujutsu なら jj split -m <description> に対象ファイルを渡すだけですし、まちがったら undo すればすぐやり直せます。なお AI によるこれらの手順では結果はファイル単位での分割になりますが、Jujutsu を人間が操作するのであれば jj split -i でインタラクティブに行単位で分割したり、evolution log を参照して作業を行った時系列で分割したりすることも可能です。
また stacked PR を作るために作業中の branch を依存関係を持った複数の branch に分割するのは Git ではかなり面倒な作業になりますが、Jujutsu なら履歴の 1 本の枝に順番に bookmark をつけていくだけで済みます。なお GitHub 公式ドキュメントには Jujutsu を使って Stacked PRs の branch チェーンを作る手順が紹介されています4。公式に Jujutsu と Stacked PRs の相性の良さが認められているようで、興味深いです。
人間の認知に優しい Jujutsu は AI の認知にも優しい
Jujutsu は機能優先な Git の pain point(つらいところ)を解消することを目指し5、人間の認知負荷を極力低くする設計になっているバージョン管理ツールです。人間の認知に優しいということは、AI の認知にも優しいということでもあります。ファイルの変更が履歴に記録されているかを気にする必要がなく、作業ディレクトリの状態がそのままカレントの履歴ポイントとして扱われる。履歴の基本単位の change は改訂を重ねても ID が不変のため、長い試行錯誤の中でも見失うことがない。operation log がすべての操作を時系列で記録しているため、自分がどの操作でまちがえたかを把握・復元しやすい。作業中に conflict が発生しても、すべての conflict を抱えた状態がいったん履歴に保存されるため、慌てることなく何度でも解消を試行できる。これらの特徴は、AI が操作するうえでも大きなメリットです。
Jujutsu は Git と同じレベルで AI エージェントにネイティブサポートされているわけではありませんが、Git よりもずっとその認知に優しく、それが動作の安定性と安全性に結びつきやすい。コーディングだけでなくバージョン管理の操作も AI に任せるという前提であっても、それに Jujutsu を使うというのは理に適った選択なのです。
上記は私の持論ですが、拙著『じゅじゅちゅ! jj new で始める Jujutsu × AI ワークフロー』の「第 1 章 Jujutsu ってどんなツール?」でも展開しており、そちらでは各機能の紹介に絡めてくわしく書いてあります。また「第 3 章 実践 Jujutsu × AI ワークフロー」では、実際に Claude Code や Codex にどうやって Jujutsu の操作を任せるかをハンズオン形式で紹介しています。
じゅじゅちゅ! jj new で始める Jujutsu × AI ワークフローJujutsu(jj)を Claude Code など用いた AI コーディングに活用するための実践ガイド。自動スナップショット、いつでも取り消せる操作、安全な履歴の書き換えで、AI が生んだ大量の変更をレビューできる履歴に変えます。
この記事で「Jujutsu いいじゃん」と思われたら、ぜひこちらの本もチェックしてみてください。
Footnotes
-
正確には何らかの
jjコマンドが実行されたタイミングで、working copy の状態と直近の履歴の状態に差分があればスナップショットが取られ、change が改訂される。また何らかの Jujutsu の UI ツールを導入すれば、通常そこで履歴を確認したときに自動スナップショットが走る。 ↩ -
ただし description が設定されていない change はリモートに push できません。 ↩
-
「Solving Git’s Pain Points with Jujutsu (with Martin von Zweigbergk) - YouTube」 ↩