«Si un agente de IA ya se encarga de Git, ¿para qué aprender otro sistema de control de versiones como Jujutsu?»
Esa fue la objeción más repetida a mi último artículo, 15 años de Git y luego Jujutsu: por qué ya no puedo volver. Es una pregunta razonable y, además, interesante, así que este artículo es mi respuesta.
Estoy de acuerdo en que el control de versiones del día a día es trabajo para un agente de IA. Así es exactamente como trabajo yo. La diferencia es que los comandos que ejecutan mis agentes son de Jujutsu, no de Git. Después de probar las dos cosas, estoy convencida de que, incluso cuando la IA va al volante, Jujutsu ofrece una experiencia de desarrollo mucho mejor, y de que el tiempo que inviertes en aprenderlo se recupera enseguida.
Antes de exponer mis argumentos, conviene despejar una duda evidente: ¿de verdad la IA sabe manejar Jujutsu? Lo comprobé con Opus, GPT, Gemini y otros. Los modelos más recientes ya conocen los conceptos básicos y los comandos principales de Jujutsu, y pueden encargarse de las operaciones cotidianas sin cargar ningún skill adicional. Eso sí, Jujutsu no está tan integrado en las herramientas de los agentes como Git, así que hace falta algo de configuración para evitar que el agente vuelva a Git sin avisar y para enseñarle un flujo de trabajo adecuado para Jujutsu. Esta es la configuración que uso yo.
La ceremonia del commit en Git frente a los changes sin fricción de Jujutsu
En Git, la unidad básica del historial es el commit. El flujo estándar es este: editas archivos en el working tree, eliges los que quieres y los añades al índice, y después escribes un mensaje y creas un commit. Solo entonces queda algo registrado en el historial. Un commit está pensado para ser un producto terminado, algo que se elabora con cuidado, y por eso Git te ofrece el índice como área de staging. Editar un archivo y lograr que esos cambios queden registrados en el historial exige una secuencia de pasos larga y rígida. Es casi un ritual.
Así que, aunque le cedas Git a una IA, sigues terminando cada tarea pidiéndole «haz commit de esto». Pide cualquier operación sobre el historial a mitad de una tarea y llega el intercambio de siempre: «Tienes cambios sin commit. ¿Los guardo en el stash o hago commit primero?». Cada ronda quizá solo lleve medio minuto, pero ocurre constantemente y todo suma. También hay un costo cognitivo, que pagan tanto tú como la IA, lo notes o no.
En Jujutsu, la unidad básica del historial es el change. Cuando inicializas un repositorio, empiezas en un change vacío. Cada edición que haces ahí se guarda sobre la marcha como una nueva revisión de ese change1. Puedes añadirle una descripción, el equivalente en Jujutsu a un mensaje de commit, cuando quieras. Un change nunca tiene un momento en que quede oficialmente «terminado»2. Cuando acabas el trabajo, simplemente pasas a otra cosa.
Eso significa que, cuando una IA maneja Jujutsu por ti, basta con una instrucción permanente: empezar cada tarea en un change nuevo con su descripción3. A partir de ahí solo tienes que decir «crea la funcionalidad X», y tu historial queda dividido en unidades razonables que siguen el hilo del trabajo. Se acabó el «haz commit de esto» al final de cada tarea, y se acabó que te pidan ordenar la copia de trabajo antes de una operación sobre el historial.
Jujutsu es compatible con Git, pero no hay ningún índice entre tu directorio de trabajo y tu repositorio local. Es más, el estado de tu directorio de trabajo es el punto actual del historial (Jujutsu lo llama «working copy as a commit», la copia de trabajo como commit). En Git, tanto las personas como la IA tienen que seguir la pista de tres estados por cada cambio en un archivo. En Jujutsu, normalmente hay solo uno. Solo después de pasarme a Jujutsu me di cuenta de cuánto esfuerzo mental extra gastaba en ajustarme a la forma de hacer las cosas de Git, y de lo estresante que era todo ese llevar la cuenta.
Habrá quien diga que esto no le molesta en absoluto. Me parece bien. Hay mucha gente a la que de verdad no le importa ponerse traje y estar en la oficina a las 8:30 cada mañana. Pero imagina pasar de eso a un trabajo sin código de vestimenta, con horario flexible y trabajo remoto hasta tres días por semana, y encontrarlo tan cómodo que ya no podrías volver atrás. Eso es lo que sentí con el cambio.
Jujutsu hace que los errores de la IA sean fáciles de deshacer
Las personas cometemos errores, y la IA también. Todavía veo de vez en cuando casos de agentes de IA que borran archivos con los que alguien estaba trabajando, sin forma de recuperarlos. Pídele a un agente que resuelva un conflicto y no es raro recibir un resultado que pasa los tests pero está roto a nivel semántico. Y como a los agentes se les dan instrucciones en lenguaje natural, un prompt no siempre transmite bien tu intención, así que a menudo no te convencerá lo que recibes.
Cuando la IA ejecuta comandos de Git como parte de su trabajo, recuperarse de un mal resultado se vuelve muchísimo más difícil. Git no tiene forma de devolver todo el repositorio al estado en que estaba antes de una operación concreta. Como comenté, Git guarda el estado en varios sitios: el working tree, el índice, el stash y los commits, y cada uno está protegido a su manera, si es que lo está. Rebase, amend y squash no modifican los commits existentes. Crean otros nuevos y mueven la rama hacia ellos, de modo que los commits originales ya no están referenciados por ninguna rama. Siguen en el reflog, pero encontrar la entrada correcta después, enterrada entre todo lo demás, es un verdadero dolor de cabeza.
Para compensar que Git no guarda los cambios sin commit, Claude Code ofrece el comando /rewind, que devuelve el código a un punto anterior junto con la conversación. Pero no se lleva bien con un agente que ejecuta comandos de Git. Tus archivos vuelven atrás, pero el estado de Git no, así que de repente git status muestra un montón de cambios que nunca quisiste, y otra vez te toca poner orden en el historial. Y lo que se haya cambiado con comandos de shell, a mano o mediante otros agentes que se ejecutan en paralelo no se revierte en absoluto.
Si detectas un error en el momento, todavía vas bien. Pero lo más habitual es que salga a la luz más tarde, cuando ejecutas los tests después de seguir trabajando o cuando revisas las cosas días después. Para entonces es mucho más difícil desenredarlo. Se han acumulado más operaciones encima de la errónea y, aunque te emplees a fondo con el reflog, nada garantiza que una larga serie de pasos delicados vaya a arreglarlo. Peor aún, Git no te da ninguna forma de deshacer el propio intento de recuperación. Una IA que prueba un arreglo tras otro para salir del agujero puede empeorar las cosas con facilidad.
Jujutsu resuelve casi todo esto. Por regla general, el resultado de cualquier comando jj se puede revertir con jj undo, y el propio undo se puede deshacer con jj redo. Esto es posible porque Jujutsu lleva, aparte del log normal, un registro de cada operación que modifica el repositorio: el operation log. Cada entrada del operation log está ligada a una instantánea del repositorio tal como quedó al terminar esa operación. Puedes restaurar los archivos a ese estado, o revertir solo el efecto de esa operación conservando todo lo que vino después.
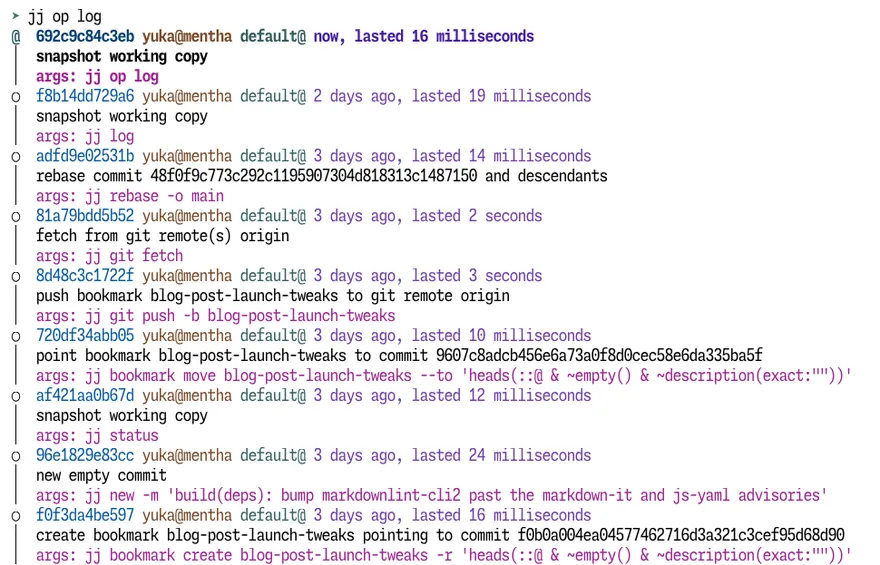
Cada comando jj que ejecuta una IA durante una larga sesión de ensayo y error también queda en el operation log. Cuando algo sale mal, puedes repasar todo lo que hizo la IA, localizar la causa y volver al estado justo anterior a que las cosas se torcieran.
Además, a diferencia del hash de un commit de Git, que cambia cada vez que editas el commit, el change ID de Jujutsu se mantiene igual por muchas veces que se revise el change. Puedes consultar el historial de revisiones de un change en el evolution log y, con un poco de trabajo, seguirle la pista hacia atrás y restaurar el contenido de una versión anterior. Si lo acotas por fecha y hora o por diff, puedes incluso recuperarte de una resolución de conflictos fallida de hace varios días y volver a hacerla.
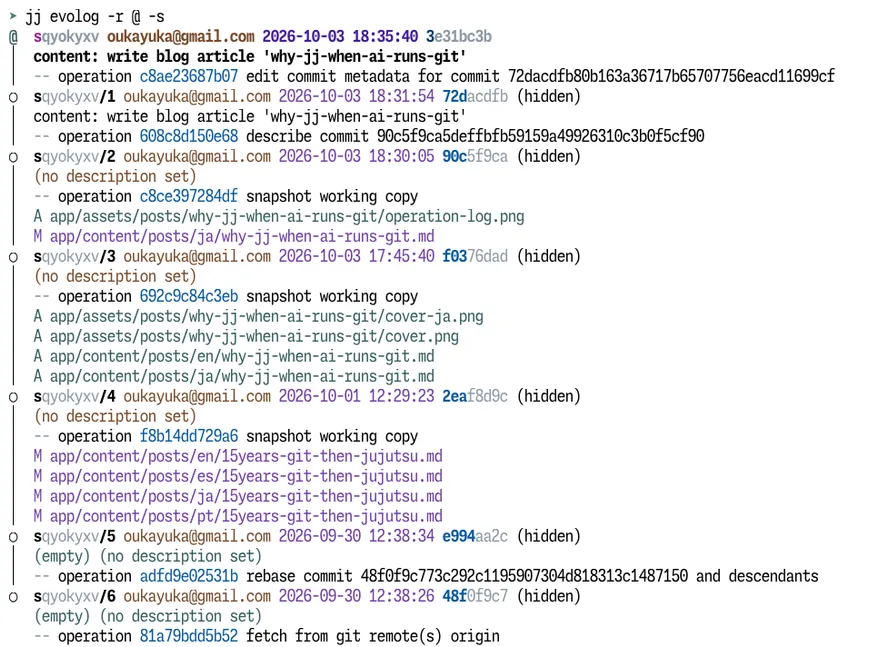
Cada edición se guarda en el historial sobre la marcha. El operation log y el evolution log te permiten encontrar dónde se torcieron las cosas y volver a ese punto. Y si la propia recuperación sale mal, jj undo y jj redo te dejan intentarlo de nuevo al momento. Es un nivel de seguridad que Git sencillamente no ofrece. Por eso, con Jujutsu me siento mucho más cómoda delegando el control de versiones a una IA y dejando que actúe con más audacia.
Por qué un historial limpio importa más en la era de la programación con IA
Otro comentario que destacó en mi último artículo fue «no me importa mantener el historial limpio, así que no le veo sentido a Jujutsu». El razonamiento parece ser que, aunque el historial sea un desastre, basta con pedirle a la IA que encuentre lo que necesites. Pero ¿es realmente así? Yo diría que es al revés: precisamente porque con la IA escribimos y leemos menos código, un historial limpio importa más que nunca.
Los agentes de programación han mejorado tanto que muchos desarrolladores ya apenas escriben código y tampoco leen cada línea que genera la IA. Aun así, siguen velando por la calidad de lo que se publica, ya sea haciendo que un agente con otro modelo revise el trabajo o revisando por su cuenta las partes críticas, como los cambios en las estructuras de datos. Si puedes rastrear directamente en el historial qué cambió, por qué y de qué depende, todo eso se hace más rápido y con menos errores. Precisamente porque nadie revisa cada línea, tu historial de commits tiene que funcionar como el índice del código, para que puedas encontrar las partes que importan. Una sucesión de commits gigantes sin una intención clara obliga a la IA a cargar contexto irrelevante cada vez, lo que consume tokens y puede perjudicar la calidad de su trabajo.
Al empezar cada sesión, lo normal es que un agente mire los diffs significativos más recientes antes que el directorio de trabajo en su conjunto. Mete «una corrección de bug + una actualización de dependencias + contenido sin relación + una refactorización que no viene a cuento» en un solo commit, y el agente se confunde. Ordena commits de tamaño razonable y con una intención clara, en una secuencia que refleje la relación de causa y efecto, y hasta un prompt corto le dará al agente el contexto que necesita para la siguiente tarea.
Y aunque durante el desarrollo apenas leas el código que genera la IA, un incidente te obligará a leerlo con atención. La primera pregunta ante una caída en producción es «¿cuándo y dónde entró el código problemático?». Cuando cada minuto cuenta, un historial de commits semánticamente coherentes te ayuda a localizar el problema rápido.
La programación con IA también ha creado un problema nuevo al disparar la productividad: los PR se vuelven enormes → cuesta revisarlos → los PR sin fusionar se acumulan esperando revisión. Ahora incluso equipos de unas pocas personas caen en ese círculo. Grandes tecnológicas como Google y Meta llevan más de una década lidiando con este problema, y su respuesta ha sido «dividir los PR en unidades pequeñas que dependen unas de otras». Supón que normalmente enviarías una funcionalidad entera como un solo PR. En su lugar, la divides en «1. cambios en la capa de modelo», «2. cambios en las tareas programadas», «3. cambios en la API del servidor» y «4. cambios en el frontend web», y los apilas 1 → 2 → 3 → 4. Cada uno se puede revisar, aprobar y fusionar por separado, pero un PR solo se puede fusionar cuando ya se han fusionado los que tiene debajo en la pila (para el 3, el 1 y el 2). Estas empresas lo integraron en sus herramientas y lo usaban en el desarrollo del día a día.
Los PR pequeños y con un papel lógico claro les ponen las cosas más fáciles a los revisores, y es más fácil identificar los que te toca revisar. Los cambios en la rama de un PR situado más abajo en la pila se propagan automáticamente a las ramas de encima, a las que las herramientas aplican el rebase. Y gracias a las dependencias, puedes empezar con seguridad la siguiente parte del trabajo mientras el primer PR sigue esperando revisión. Esto es lo que se suele llamar stacked diffs o stacked PRs. Graphite, GitButler, GitLab y otros llevan años incorporándolo. Y en julio de 2026, GitHub por fin lanzó los stacked PRs en vista previa pública. Con el actor principal ya a bordo, todo apunta a que la tendencia va a acelerarse.
Con la generalización de los monorepos y el impacto de los agentes de IA, la demanda de stacked PRs está creciendo no solo en las grandes empresas, sino también en las pequeñas y medianas. Cuando los stacked PRs forman parte de la forma de trabajar de un equipo, organizar bien las unidades del historial y su orden pasa a ser parte del trabajo de cada desarrollador. Los PR en los que antes cabía cualquier cosa, ahora hay que dividirlos según su papel lógico, con dependencias entre ellos. Y Jujutsu hace que eso sea fácil y seguro.
Pensemos en dividir un commit gigante en unidades con sentido. Es una tarea difícil, incluso para la IA. En Git, probablemente harías git reset HEAD^ para devolver todo el commit al working tree y luego repetirías el ciclo de añadir al índice y hacer commit, parte por parte. Si te equivocas por el camino, recuperarte implica averiguar exactamente hasta dónde llegaste con la división y qué ediciones quedaron dónde, lo que ya es un dolor de cabeza en sí mismo. Y si el commit que quieres dividir es antiguo, te espera la emoción de encadenar rebases con un HEAD desacoplado (detached HEAD). En Jujutsu, le pasas los archivos a jj split -m <description> y listo. Si te equivocas, deshaces y vuelves a intentarlo. Cuando lo hace una IA, la división es a nivel de archivo, pero una persona que maneje Jujutsu puede usar jj split -i para dividir de forma interactiva línea a línea, o consultar el evolution log y dividir el trabajo en el orden en que realmente se hizo.
Convertir una rama de trabajo en una cadena de ramas dependientes para un stacked PR es bastante complicado en Git. En Jujutsu, basta con ir poniendo bookmarks, uno tras otro, sobre una sola línea del historial. La documentación oficial de GitHub incluso explica paso a paso cómo crear la cadena de ramas de un stacked PR con Jujutsu4. Es genial ver esa compatibilidad reconocida oficialmente.
Lo que es fácil para las personas también lo es para la IA
Git se diseñó poniendo las funcionalidades por delante de quien las usa. Jujutsu es un sistema de control de versiones creado para resolver los puntos débiles de Git5 y para reducir al mínimo la carga cognitiva de las personas. Y lo que le resulta fácil a la mente humana también le resulta fácil a la IA. Nunca tienes que preocuparte de si una edición ha llegado al historial, porque el estado del directorio de trabajo es el punto actual del historial. Un change conserva el mismo ID por muchas veces que se revise, así que nunca se pierde durante largas rondas de ensayo y error. El operation log registra cada operación en orden, así que es fácil ver qué paso salió mal y restaurar desde ahí. Y cuando surge un conflicto a mitad de una tarea, el propio estado en conflicto se guarda en el historial, así que puedes tomarte tu tiempo e intentar resolverlo tantas veces como haga falta. Cada una de estas características es una gran ventaja cuando es la IA quien está a los mandos.
Jujutsu no está tan integrado en las herramientas de los agentes de IA como Git. Pero les resulta mucho más fácil de entender, y eso tiende a hacer su trabajo más estable y seguro. Aunque le cedas a la IA el control de versiones junto con la programación, elegir Jujutsu para esa tarea tiene todo el sentido.
Esa es mi opinión, y también el argumento que desarrollo en el «Capítulo 1: ¿Qué clase de herramienta es Jujutsu?» de mi libro, Juju-chu! —Comienza tu flujo de trabajo Jujutsu × IA con `jj new`. Ese capítulo recorre el mismo argumento funcionalidad por funcionalidad. El «Capítulo 3: El flujo Jujutsu × IA en la práctica» es una guía práctica para cederles de verdad el manejo de Jujutsu a Claude Code y Codex.
Juju-chu! —Comienza tu flujo de trabajo Jujutsu × IA con `jj new`Una guía práctica para adoptar Jujutsu (jj) junto a Claude Code y Codex: snapshots automáticos, operaciones que siempre se pueden deshacer y una reescritura del historial que es segura.
Si este artículo despertó tu curiosidad por Jujutsu, échale un vistazo.
Footnotes
-
Para ser exactos, cada vez que se ejecuta cualquier comando
jj, Jujutsu compara la copia de trabajo con el último estado del historial. Si hay diferencias, toma una instantánea y el change recibe una nueva revisión. Si usas una interfaz gráfica de Jujutsu, normalmente toma una instantánea automáticamente cada vez que consultas el historial en ella. ↩ -
Eso sí: un change sin descripción no se puede enviar al remoto con push. ↩
-
Consulta Haz que tu agente de programación use Jujutsu en vez de Git. ↩
-
Uso de otras herramientas con solicitudes de incorporación de cambios apiladas - Documentación de GitHub ↩
-
Solving Git’s Pain Points with Jujutsu (with Martin von Zweigbergk) - YouTube ↩