2026: o primeiro VCS que escolhi de verdade
Olhando para trás, eu nunca cheguei a escolher um sistema de controle de versões (VCS). Usava o que a empresa onde eu trabalhava tivesse adotado. Na maioria dos meus empregos anteriores, usava-se Subversion em um servidor interno. Até que, em 2011, entrei em uma empresa que tinha adotado o GitHub, o que significava que todos os engenheiros precisavam usar Git. Foi aí que comecei a usar Git e GitHub para valer.
Vindo do Subversion, o Git me parecia pouco intuitivo e difícil de usar. O GitHub também trouxe uma nova exigência: deixar o histórico limpo para facilitar a revisão. Os comandos para isso eram inconsistentes e difíceis de memorizar, e cada um vinha com aquela pressão de saber que não dava para errar.
Com o tempo, aquela frustração foi amortecendo e eu aceitei que as coisas eram assim. Mesmo assim, continuava sem conseguir memorizar os comandos. Qualquer coisa um pouco mais complicada exigia uma busca no Google, e eu evitava tudo o que pudesse causar um conflito. Assim se passaram cinco anos, depois dez. Justo quando parecia que os quinze passariam do mesmo jeito, tudo mudou. Chegaram os agentes de IA para programação, como o Claude Code, e, quase sem eu perceber, a IA já escrevia mais código do que humanos. Alguns anos antes, eu não teria acreditado.
Dê instruções a uma IA e ela escreve o código num piscar de olhos. Com tudo andando tão rápido, o ritual trabalhoso de fazer add e depois commit no Git virou um verdadeiro gargalo. Se funcionava, eu fazia o commit por enquanto, mesmo sem ainda entender o código tão a fundo quanto o que eu mesma tinha escrito. E depois, inevitavelmente, queria mudar coisas. Perdia alterações importantes em algum ponto do inferno do rebase, ou desistia e empilhava commits de remendo por cima até o histórico virar uma bagunça. Isso passou a fazer parte do dia a dia.
Foi então que encontrei o Jujutsu. No Japão, por volta de janeiro de 2026, uma leva de artigos introdutórios circulou bastante, e a comunidade de desenvolvedores em geral começou a prestar atenção nele. Depois de ler alguns, achei que ele combinaria bem com a programação com IA e o experimentei em um projeto em que eu estava trabalhando. A filosofia de design e os comandos são tão diferentes dos do Git que, no começo, tive muita dificuldade para usá-lo. O que me impediu de desistir foi a simplicidade de trabalhar sem staging area e a tranquilidade de saber que qualquer operação podia ser desfeita. Depois de mais ou menos um mês, eu já conseguia usá-lo razoavelmente bem.
Desde então, gerencio todos os meus repositórios com o Jujutsu, e também escrevo tudo com ele, de posts de blog e documentação a manuscritos de livros (este post incluído, claro). Pensando bem, trocar o Git pelo Jujutsu foi a primeira vez que escolhi um VCS por conta própria. E, em algum momento, percebi que não conseguia mais voltar ao Git. Estas são, na minha visão, as razões pelas quais não tenho a menor vontade de voltar.
Razão 1: nunca preciso me perguntar se meu trabalho está salvo
O Git usa um modelo de três estados: working tree → índice → repositório local. Para registrar uma alteração no histórico, primeiro você a coloca em staging com git add e depois executa git commit. No Jujutsu, o estado da sua cópia de trabalho (working copy) já é, em si, um commit. Do ponto de vista do Jujutsu, não existe diferença entre o seu diretório de trabalho e o commit atual. Isso traz algumas vantagens práticas:
- Você nunca precisa decidir quando salvar no histórico
- Você não precisa de nada parecido com
git stashao trocar de tarefa - É muito improvável que você perca trabalho em andamento
Controlar quais arquivos ainda não estão em staging ou ainda não entraram em um commit é uma carga cognitiva que não tem nada a ver com o trabalho de desenvolvimento em si. O mesmo vale para guardar e recuperar stashes quando algo inesperado interrompe você. O Jujutsu reduz esses custos a quase zero.
Na programação com IA, com a configuração certa, basta pedir a um agente “crie a funcionalidade X”. O trabalho vai sendo registrado em um único commit à medida que avança, e o agente o finaliza com uma mensagem como “feat: X”. No fluxo normal, você não precisa cuidar do histórico em nenhum momento.
Você também quase nunca passa pela situação de ver git reset, git clean ou um comando do shell apagar arquivos que não dá mais para recuperar. Eu mesma já tive arquivos apagados por um agente de IA sem conseguir recuperá-los e, mesmo hoje, com modelos supostamente muito melhores do que antes, ainda vejo relatos assim de vez em quando. O Jujutsu faz commit da cópia de trabalho conforme você trabalha1, então, na maioria dos casos, qualquer coisa apagada por engano pode ser recuperada do histórico.
Se eu fosse obrigada a voltar ao Git, teria que voltar a pensar em salvar, e estaria sempre a um comando errado de perder o trabalho em andamento. Só de imaginar, já fico cansada. O Jujutsu reduz a carga cognitiva do controle de versões e me dá tranquilidade.
Razão 2: experimentar fica muito mais barato
Agora que um agente de IA consegue construir em instantes o que eu pedir, faço muito mais tentativa e erro: construir algo, ficar com o resultado se estiver bom e jogar fora e recomeçar se não estiver. Fazer isso no Git logo fica complicado. Se você experimenta na working tree sem fazer commit, fica sem saída quando descarta algo e depois decide que queria aquilo. Se quiser guardar no histórico, precisa de branches, e criá-los, alternar entre eles, fazer merge e apagá-los dá tanto trabalho que experimentar começa a dar preguiça.
E como o Jujutsu resolve isso? A unidade básica do histórico no Jujutsu, mais ou menos equivalente a um commit do Git, é o change. Quando o Jujutsu detecta edições na cópia de trabalho, ele atualiza automaticamente o change atual e também guarda as versões anteriores. Basta experimentar dentro de um change. Crie um novo com jj new e teste o que quiser. Se gostar do resultado, dê a ele uma descrição (mais ou menos, uma mensagem de commit). Se não gostar, descarte-o com jj abandon. Se depois quiser recuperá-lo, jj operation revert <operation ID> desfaz essa operação2 e, se você acabou de descartá-lo, um único jj undo o traz de volta.
O Jujutsu também permite criar ramificações a partir de qualquer ponto do histórico sem dar nome a nada. Basta passar o ID do change pai para jj new. Para comparar abordagens diferentes para a mesma tarefa, crie vários desses changes irmãos e alterne entre eles com jj edit <change ID>. Dê uma descrição ao que quiser manter e faça jj abandon do resto. Só isso.
Como o change, a unidade básica do histórico do Jujutsu, também serve de área de testes, experimentar passa a fazer parte do fluxo de trabalho normal. Não é preciso fazer merge. E como, ao começar um experimento, você não sabe se ele vai dar certo, também não precisa dar nome a ele de antemão.
Se eu fosse obrigada a voltar ao Git, com certeza teria mais resistência a experimentar. Já me vejo deixando de criar o branch pelo trabalho que dá, experimentando na working tree, jogando algo fora, querendo recuperar e me arrependendo.
Razão 3: reescrever o histórico é simples e intuitivo
Quando eu mesma escrevia o código, eu o conhecia de trás para a frente, então meus commits eram sólidos e raramente eu precisava voltar a eles. Mas quase ninguém lê cada linha que uma IA gera e a entende tão bem quanto o próprio código antes de fazer commit. Por isso, hoje me pego querendo alterar commits supostamente prontos com muito mais frequência do que antes.
Suponha que você queira incluir uma alteração em src/styles/global.css no commit de três posições atrás. Como isso fica no Git e no Jujutsu? Há duas formas de fazer isso: editar diretamente o commit em questão ou fazer a alteração por cima e incorporá-la (squash) a esse commit. Aqui vou comparar a primeira.
Vamos começar pelo Git. Não dá para fazer isso com alterações sem commit no caminho, então, se houver alguma, primeiro você precisa guardá-las com git stash -u. Depois:
git rebase -i HEAD~4No editor que se abre, troque pick por edit na linha do commit em questão e salve.
pick bbbbbbb Mensagem do commit Bedit bbbbbbb Mensagem do commit Bpick ccccccc Mensagem do commit Cpick ddddddd Mensagem do commit Dpick eeeeeee Mensagem do commit EAgora sua working tree está no commit B. Edite src/styles/global.css e faça o commit.
git add src/styles/global.cssgit commit --amend --no-editMas ainda não acabou. Os commits seguintes ainda precisam ser reaplicados sobre essa edição. Execute git rebase --continue e reze para não haver conflito. Se houver, o rebase para, e você precisa corrigir os arquivos, fazer git add e executar git rebase --continue de novo, quantas vezes forem necessárias. Se você se perder no meio do caminho, git rebase --abort leva você de volta à estaca zero. É cansativo.
Agora, a mesma coisa no Jujutsu. jj edit @--- move a cópia de trabalho para o change de três posições atrás. Edite src/styles/global.css. O Jujutsu faz automaticamente o rebase dos changes descendentes sobre ele, então, se não houver conflitos, pronto. Mesmo que surja um conflito, o rebase automático termina sem parar. Basta ir com jj edit até o change em conflito e corrigi-lo ali, e o rebase automático é executado de novo.
Ter menos passos é um bônus, mas a grande vantagem é que tudo fica muito mais intuitivo. Você vai até o ponto do histórico que interessa e edita os arquivos. O Jujutsu cuida do rebase por conta própria, então você mal percebe que ele está acontecendo. No Git, por algum motivo, o rebase é o protagonista. Você começa com git rebase e termina com git rebase. É contraintuitivo, e os passos intermediários são tão trabalhosos que nunca consegui memorizá-los.
Se eu fosse obrigada a voltar ao Git, provavelmente evitaria reescrever o histórico sempre que pudesse, por causa do trabalho que dá. Commits de remendo se acumulariam, ou alterações sem relação acabariam enfiadas em qualquer commit que estivesse à mão, e meu histórico ficaria muito mais difícil de ler.
Razão 4: vejo o histórico como um grafo, não só como uma linha do tempo
Vamos começar comparando a saída do comando de log de cada ferramenta. A primeira é do git log; a segunda, do jj log. Por padrão, o Jujutsu oculta a maioria dos changes imutáveis, então passei -r :: para remover essa limitação.
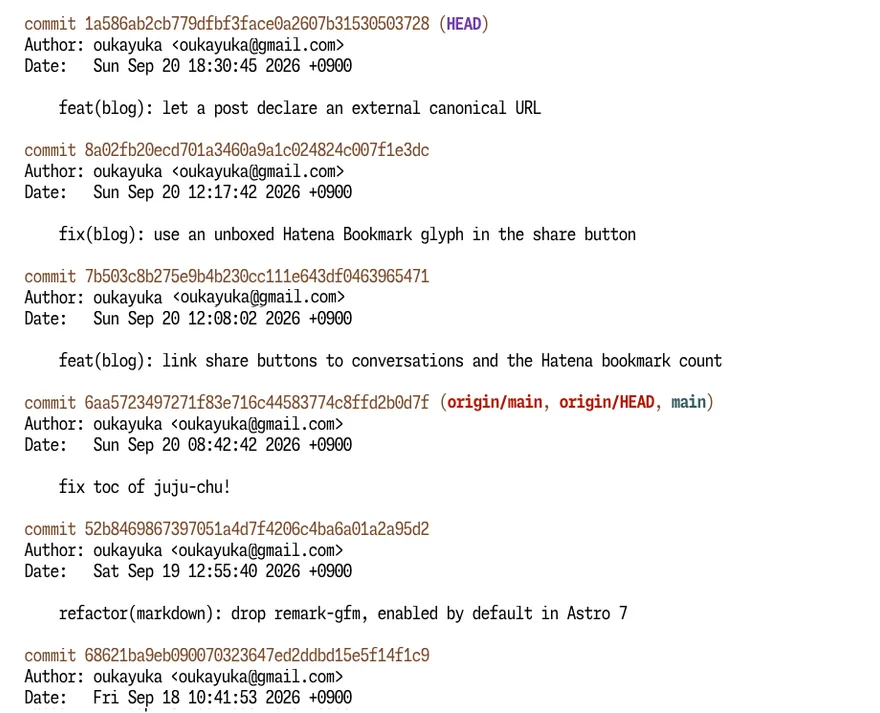
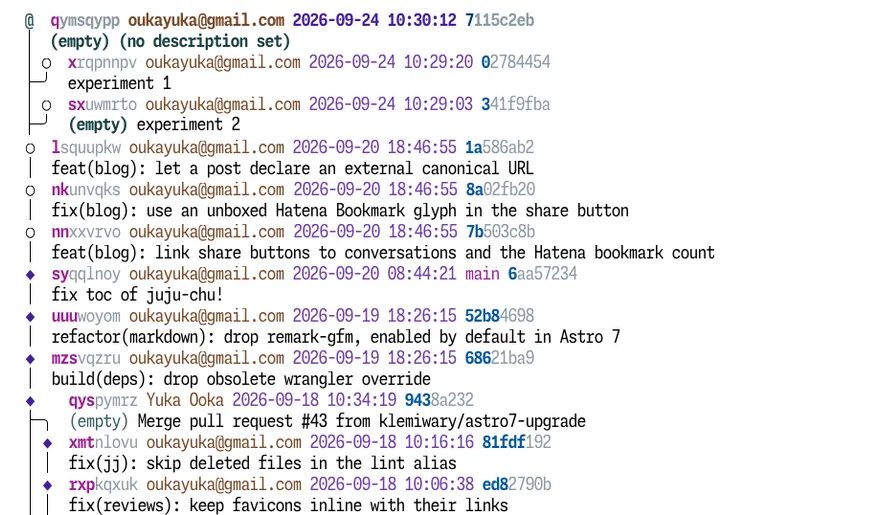
O log do Git mostra o que aconteceu no seu branch atual, em ordem e em linha reta, como a cronologia de um livro de história. O log do Jujutsu oferece uma visão panorâmica de todo o histórico, desenha as ramificações com arte ASCII e concentra mais informação. Num relance, você absorve muito mais.
O que acontece quando você vai para um ponto passado do histórico também é diferente. Execute git checkout <commit ID> no Git, e o git log deixa de mostrar o que vem depois desse ponto. Execute jj edit <change ID> no Jujutsu, e o log continua como estava. Só a marca @, que representa o commit da cópia de trabalho, se move para o nó desse change.
Essas diferenças na aparência e no comportamento do log dizem muito sobre a filosofia de design de cada ferramenta. No Git, em princípio, espera-se que você esteja em algum branch com nome enquanto trabalha, e você está sempre sendo empurrado para a ponta dessa única linha do histórico. Talvez seja por isso que o log padrão nem se dá ao trabalho de mostrar onde você está no histórico como um todo nem o que acontece fora dessa linha3.
O Jujutsu não tem nada que corresponda aos branches com nome do Git4. Você pode ir livremente para qualquer nó editável do histórico, esteja ele na linha que estiver. É por isso que um grafo do histórico completo é tão útil.
Reescrever o histórico no Jujutsu é fácil, em boa parte, graças a esse log denso e legível. É como trabalhar em um programa de edição de vídeo com uma linha do tempo de várias trilhas à sua frente. Em comparação, editar o histórico no Git parece cortar filme analógico com tesoura e colar os pedaços de volta.
O git log também consegue desenhar uma árvore em arte ASCII se você passar --graph, embora não seja tão legível quanto a do Jujutsu. Mas ver o grafo não permite editar entre branches de forma intuitiva e segura como no Jujutsu, então, mesmo que eu voltasse ao Git, quase não o usaria.
O lugar do Git hoje
Já faz mais de seis meses que migrei totalmente para o Jujutsu, mas, na verdade, não parei de usar o Git. A camada de armazenamento do Jujutsu é plugável, e ele pode usar um repositório Git como backend. Quando você inicializa um repositório com o Jujutsu, por padrão obtém um colocated workspace, com .git/ e .jj/ lado a lado na raiz do projeto. Continuo usando um repositório Git; só deixei de usar a interface do Git para trabalhar com ele. O comando git continua funcionando, se você precisar.
Graças a essa compatibilidade, ninguém ao seu redor vai saber que você usa o Jujutsu, a menos que você conte. Em uma equipe que usa GitHub ou GitLab, é perfeitamente possível que alguém esteja usando o Jujutsu discretamente esse tempo todo. No dia a dia, praticamente as únicas vezes em que penso no Git são quando preparo um repositório com jj git init ou jj git clone e, a partir daí, quando sincronizo com o remoto usando jj git fetch e jj git push.
Comecei a usar o Git por causa do GitHub e troquei pelo Jujutsu quando mergulhei de vez na programação com IA. Agora não tem mais volta. Depois de tantos anos acostumada ao Git, alguns jeitos do Jujutsu me pareceram estranhos no começo. Mas, olhando para a história do controle de versões, muitas vezes o estranho era o Git, e hoje o Jujutsu me parece mais natural na maioria das situações.
Ainda assim, o Jujutsu continua sendo pouco conhecido, e me frustra que uma ferramenta tão boa não tenha mais visibilidade. O problema é que ele é compatível com o Git, mas se baseia em um modelo mental muito diferente. Se você o experimentar com a cabeça no Git, guiando-se por uma tabela de equivalência entre comandos do Git e do jj, mal vai notar as vantagens. Por isso escrevi um guia de Jujutsu para iniciantes pensado para você não travar no caminho, centrado em ajudar você a adotar esse novo modelo mental.
Juju-chu! — O guia de Jujutsu para programar com agentesUm guia prático para adotar Jujutsu (jj) com Claude Code e Codex: snapshots automáticos, operações que podem ser desfeitas e reescrita segura do histórico.
Ele se chama Juju-chu! — Comece seu fluxo de trabalho Jujutsu × IA com `jj new`. O livro tem uma capa no estilo light novel e um visual divertido, mas o conteúdo é sério. O livro orienta você passo a passo, desde os primeiros contatos com o Jujutsu até você conseguir usá-lo com confiança. Se este post despertou sua curiosidade pelo Jujutsu, dê uma olhada. Na página, você encontra uma amostra que pode ler diretamente no navegador.
Footnotes
-
Para ser exata, sempre que qualquer comando
jjé executado, o Jujutsu verifica se há diferenças entre a cópia de trabalho e o estado mais recente do histórico e, se houver, faz o commit. Agentes de IA instruídos a usar o Jujutsu costumam conferir o próprio trabalho comjj statusou um comando parecido nas pausas naturais de uma tarefa, e é nesse momento que o commit acontece. ↩ -
Além do log normal, o Jujutsu mantém um registro de operações com cada operação realizada no repositório. Cada entrada tem um ID de operação, que você pode usar para reverter essa operação ou restaurar os arquivos como estavam logo depois dela. ↩
-
Refiro-me ao comportamento padrão. Com
--all, você vê todos os branches do seu repositório local e os commits alcançáveis a partir deles. ↩ -
Os bookmarks do Jujutsu são tratados como branches ao trabalhar com o Git, mas, conceitualmente, são outra coisa. ↩